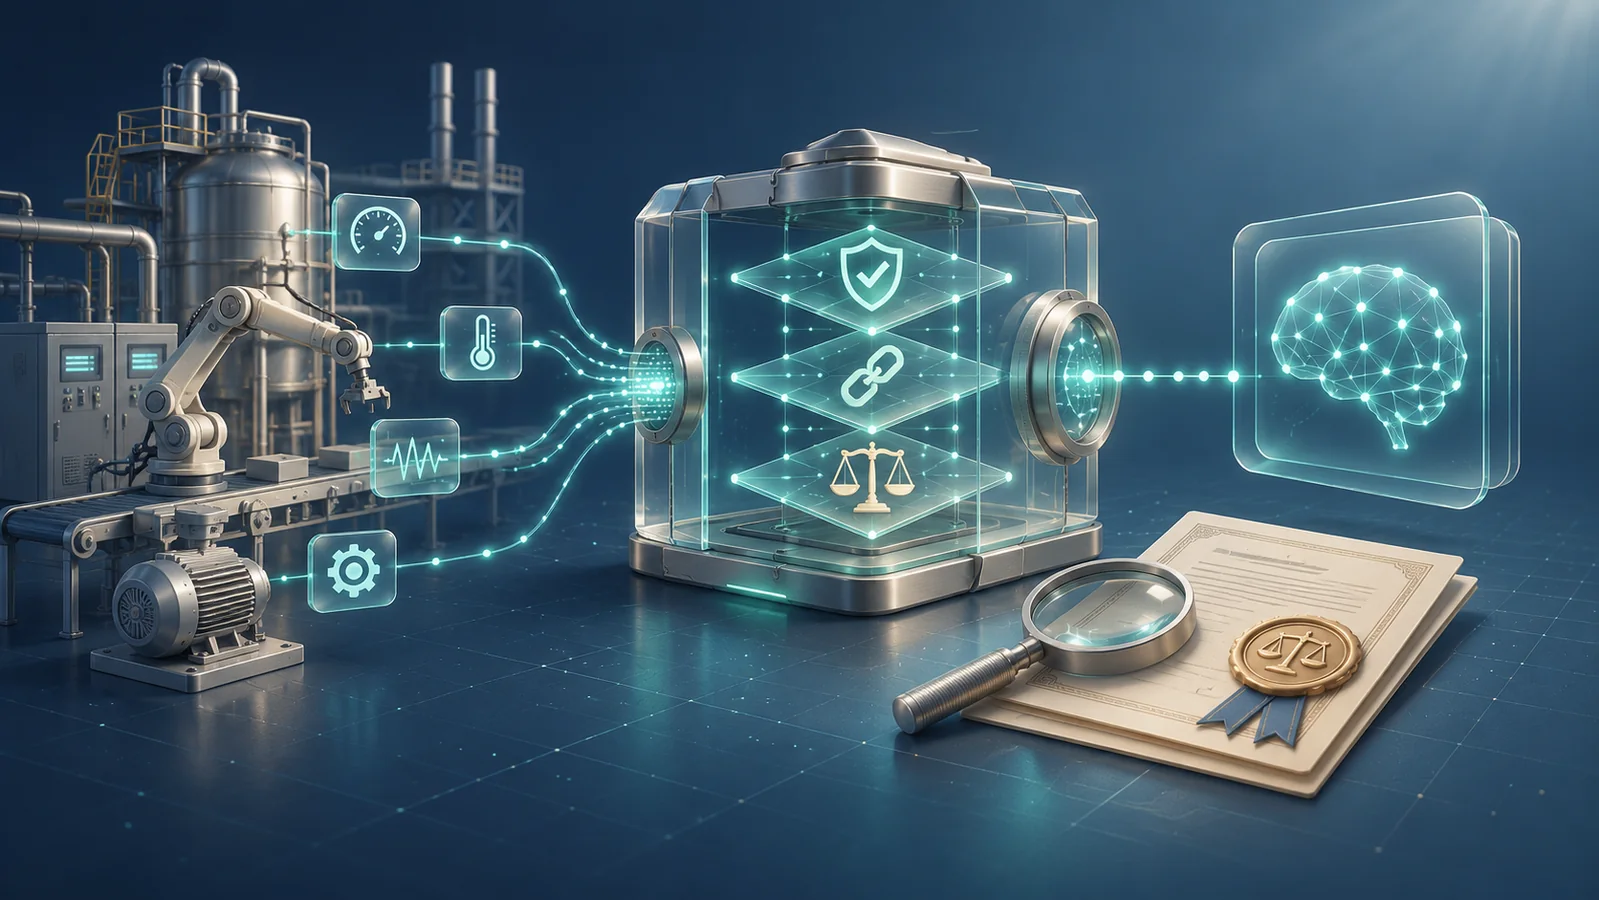
L’Internet des objets industriels (IIoT) génère chaque jour des pétaoctets de mesures provenant de capteurs, d’automates programmables et de systèmes embarqués. Pour les exploiter en IA, ces flux doivent être fiables, traçables et opposables lors d’un audit ou d’une procédure juridique. L’article présente les exigences techniques, organisationnelles et réglementaires à respecter pour transformer les signaux du terrain en jeux de données certifiés, utilisables pour des modèles prédictifs, des tableaux de bord décisionnels ou des procédures de conformité. Il décrit une architecture de référence et les pratiques de gouvernance, de qualité et de sécurité, puis les illustre par un cas de maintenance prédictive dans l’industrie lourde.
Introduction – Vérifier les données et les décisions industrielles
Les usines « smart » misent sur la collecte massive de données pour optimiser leurs lignes de production, réduire les temps d’arrêt et anticiper les pannes grâce à l’IA. Pourtant, l'abondance de données ne suffit pas : lorsqu’un modèle prédit une défaillance ou qu’une analyse statistique justifie un arrêt de ligne, les résultats doivent être vérifiables, reproductibles et défendables devant la direction, les auditeurs internes, les autorités de régulation ou les tribunaux.
Cette exigence d’opposabilité découle de plusieurs facteurs :
- la multiplication des exigences légales (RGPD, NIS2, IEC 62443) imposant une traçabilité complète du traitement des données ;
- les exigences contractuelles et d’assurance où le client ou l’assureur demande la preuve que les décisions automatisées reposent sur des jeux de données fiables ;
- la nécessité pour les industriels de justifier leurs investissements IA auprès des actionnaires par un retour sur investissement mesurable.
L’enjeu consiste à architecturer, sécuriser et gouverner le pipeline depuis le capteur jusqu’au modèle d’IA, en intégrant des contrôles de qualité et de conformité capables de résister à un examen rigoureux. Les leviers pour y parvenir sont détaillés ci-après.
1. Contexte industriel : usages et enjeux de l’IoT
| Aspect | Situation traditionnelle | Impact de l’IIoT |
|---|---|---|
| Visibilité | Données ponctuelles, historiques limitées (SCADA, rapports mensuels). | Flux continus à haute fréquence (10 Hz – 1 kHz) provenant de millions de points. |
| Temps de réaction | Décisions prises à l’issue d’enquêtes post‑incident. | Détection en temps réel, actions correctives automatisées. |
| Coût des arrêts | Estimations basées sur expérience. | Quantification précise grâce aux indicateurs de performance (OEE, MTBF). |
| Complexité du système | Architecture monolithique et centralisée. | Architectures distribuées (edge/fog) avec heterogénéité matérielle. |
Ces transformations ouvrent la voie à l’IA : les algorithmes d’apprentissage supervisé ou non‑supervisé nécessitent des volumes importants de données labellisées, synchronisées et dédupliquées. Le passage du « bruit terrain » aux jeux de données exploitables requiert un socle de gouvernance.
2 De la mesure brute à la donnée structurée : la chaîne de collecte
- Capteurs et acquisition – Les capteurs (température, vibration, courant) convertissent le phénomène physique en signal électrique. La précision du capteur, son étalonnage et sa fréquence d’échantillonnage sont les premières sources de qualité ; un mauvais calibrage se répercute sur l’ensemble du pipeline.
- Edge computing – Les passerelles edge (ex. NVIDIA Jetson, Siemens Edge‑IIoT) prétraitent localement : filtrage anti‑alias, agrégation temporelle, détection d’anomalies basiques. Cette étape réduit la latence et le volume transmis au cloud, tout en offrant une première couche de résilience pour maintenir la continuité en cas de perte de connectivité.
- Transport sécurisé – Les protocoles industriels (OPC UA, MQTT‑TLS, DDS) garantissent l’intégrité et la confidentialité des flux. Le chiffrement TLS 1.3 avec authentification mutuelle X.509 est recommandé pour éviter les attaques de type man‑in‑the‑middle.
- Ingestion dans le data lake – Les services cloud (Azure Data Lake, AWS S3, Google Cloud Storage) stockent les données brutes sous forme d’objets immuables. L’utilisation de formats colonnes compressés (Parquet, ORC) facilite la lecture ultérieure et optimise les coûts de stockage.
- Méta‑données et catalogage – Un catalogue de données (AWS Glue, Azure Purview) enregistre le schéma, l’origine, le propriétaire et les horodatages. Cette couche métadonnée assure la traçabilité juridique : chaque jeu de données devient « audit‑ready ».
Le respect de ces étapes crée une chaîne d’intégrité où chaque maillon peut être vérifié indépendamment.
3 Qualité des données industrielles : critères et méthodes d’assurance
| Critère | Définition | Méthode de contrôle |
|---|---|---|
| Exactitude | Proximité avec la vraie valeur physique. | Étallonage périodique, comparaison avec références étalons. |
| Complétude | Absence de lacunes dans le temps ou l’espace. | Monitoring des gaps d’acquisition, alertes sur pertes de paquets. |
| Cohérence | Conformité entre variables liées (ex. température vs pression). | Règles de validation croisées (data contracts). |
| Temporalité | Alignement des horodatages (synchronisation NTP/PTP). | Vérification du drift, correction via timestamps centralisés. |
| Traçabilité | Historique complet des transformations appliquées. | Journaux immuables (append‑only) avec hashage cryptographique. |
Les organisations adoptent souvent le cadre DQI (Data Quality Initiative) ou les recommandations de l’ISO 8000 pour formaliser ces contrôles. Des outils d’observabilité (Datadog, Grafana Loki) permettent de visualiser en temps réel la santé du pipeline et d’automatiser les corrections (re‑ingestion, recalibrage).
Chaque règle de qualité doit être documentée, versionnée et attribuée à un responsable. En cas de litige, celui-ci peut démontrer que les données ont été traitées conformément aux exigences établies.
4 Gouvernance et traçabilité : rendre les données opposables
4.1 Cadre de gouvernance
| Niveau | Responsable | Responsabilités |
|---|---|---|
| Stratégie | DSI / Comité de direction | Définir la politique data, budget, conformité réglementaire. |
| Gestion des actifs | Architecte IoT / Data Steward | Inventorier capteurs, cataloguer flux, assurer le cycle de vie. |
| Qualité & Sécurité | Responsable Qualité / RSSI | Mettre en place les contrôles DQ et les mesures de sécurité. |
| Exploitation | Ingénieur data / Analyste IA | Concevoir pipelines d’entraînement, monitorer la dérive des modèles. |
4.2 Traçabilité juridique
- Journalisation immuable – Chaque transformation (filtrage, agrégation, anonymisation) génère un enregistrement signé : hash(prev_record) + opération. Les solutions basées sur les blockchains privées ou les services de journalisation cloud (Azure Immutable Blob Storage) assurent l’inaltérabilité.
- Conservation – Le RGPD impose la conservation des preuves de conformité pendant 5 à 10 ans selon le secteur ; les normes IEC 62443 recommandent au minimum 7 ans pour les logs industriels.
- Accès contrôlé – Les politiques RBAC (Role‑Based Access Control) et ABAC (Attribute‑Based Access Control) limitent la lecture/écriture aux seuls acteurs habilités, avec audit complet des accès.
Ces mécanismes permettent à un audit externe de retracer le parcours des données, du capteur au résultat produit par l’IA, et d’en établir l’opposabilité.
5 Architecture technique de référence

Lire la notation du schéma
flowchart TD
    subgraph Edge["Nœuds Edge"]
        C1[Capteurs] -->|Signal analogique| EP[Passerelle Edge]
        EP -->|Filtrage & agrégation| B1[Broker MQTT‑TLS]
    end

    subgraph Fog["Couche Fog"]
        B1 -->|Transport sécurisé| S1["Service d’ingestion (Kafka)"]
        S1 -->|Topic raw_data| L1["Data Lake (S3/ADLS)"]
        S1 -->|Topic metadata| Cata[Catalogue & Méta‑données]
    end

    subgraph Cloud["Plateforme Cloud"]
        L1 -->|Parquet| DWH["Entrepôt (Snowflake/BigQuery)"]
        DWH -->|SQL/ML pipelines| ML[Entraînement modèle]
        ML -->|Modèle| API[Service d’inférence]
        API -->|Résultat IA| App[Application métier]
    end

    style Edge fill:#f9f,stroke:#333,stroke-width:2px
    style Fog fill:#bbf,stroke:#333,stroke-width:2px
    style Cloud fill:#bfb,stroke:#333,stroke-width:2px
Principaux composants
| Composant | Rôle | Options technologiques courantes |
|---|---|---|
| Passerelle Edge | Acquisition, pré‑traitement, filtrage local. | Siemens IoT2040, NVIDIA Jetson, Raspberry Pi 4 (avec OS temps réel). |
| Broker MQTT‑TLS | Distribution fiable des messages. | Eclipse Mosquitto, EMQX, Azure IoT Hub. |
| Pipeline d’ingestion | Découplage et persistance durable. | Apache Kafka + Confluent Schema Registry. |
| Data Lake immuable | Stockage brut, versionné. | Amazon S3 Object Lock, Azure Immutable Blob. |
| Catalogue de données | Gestion des schémas & gouvernance. | AWS Glue Data Catalog, Azure Purview. |
| Entrepôt analytique | Requêtes ad‑hoc, préparation IA. | Snowflake, Google BigQuery, Azure Synapse. |
| MLOps platform | Entraînement, CI/CD des modèles. | MLflow, Kubeflow Pipelines, Azure Machine Learning. |
| API d’inférence sécurisée | Exposition du modèle aux applications métier. | FastAPI + OAuth2, Istio service mesh pour contrôle d’accès. |
Cette architecture sépare les préoccupations de latence (edge) et de scalabilité (cloud), tout en assurant la cohérence transactionnelle grâce à des logs immuables et à un catalogue centralisé.
6 Sécurité & résilience du pipeline de données
| Risque | Contre‑mesure |
|---|---|
| Altération en transit | Chiffrement TLS 1.3, certificats X.509 mutuels, rotation trimestrielle des clés. |
| Compromission d’un dispositif edge | Secure Boot, TPM 2.0, mise à jour OTA signée, sandboxing du firmware. |
| Déni de service sur le broker | Limitation de débit (rate‑limiting), redondance multi‑zone, utilisation de load balancers L7. |
| Corruption des logs | Stockage en mode « append‑only », hash chaining, stockage immuable (WORM). |
| Fuite de données sensibles | Masquage / anonymisation dès le edge, politiques DLP (Data Loss Prevention), chiffrement au repos avec CMK gérées par KMS. |
La mise en œuvre du Zero Trust à chaque niveau – identité forte pour les appareils, micro‑segmentation réseau et vérification continue des comportements – est recommandée par l’ANSSI et le NIST [3].
7 Préparer les données industrielles pour l’IA
- Ingestion & nettoyage – Utiliser Spark Structured Streaming ou Flink pour transformer les flux bruts en tables de faits, appliquer des règles de validation (ex. valeurs hors limites → rejet).
- Étiquetage (labeling) – Les événements d’arrêt machine sont souvent annotés manuellement par les équipes de maintenance ; l’intégration d’outils de human‑in‑the‑loop (e.g., Scale AI, Labelbox) garantit la qualité du label et crée un audit trail.
- Feature engineering – Calcul de fenêtres glissantes (rolling averages), dérivées (vibration RMS), transformations fréquentielles (FFT) directement au niveau du stream processing. Ces features sont versionnées dans le catalogue.
- Gestion des déséquilibres – Les pannes étant rares, appliquer des techniques d’oversampling (SMOTE) ou de génération synthétique via GANs industrielles, tout en conservant la traçabilité des données synthétiques utilisées.
- Entraînement & validation – Séparer les jeux de données par temporal split pour éviter le leakage temporel ; consigner les hyper‑paramètres et les métriques (AUC, F1) dans un registre MLOps.
Ces étapes garantissent que le modèle d’IA repose sur des données certifiées, dont la provenance et la transformation sont documentées.
8 Cadre réglementaire & conformité
| Réglementation | Implication principale pour l’IIoT |
|---|---|
| RGPD (Art. 5, 6) | Consentement ou légitimité du traitement des données personnelles (ex. opérateurs de machines). Anonymisation dès le edge recommandée. |
| NIS2 (UE) | Obligation de sécuriser les réseaux et services essentiels ; notification d’incident sous 24 h. |
| IEC 62443 | Norme de cybersécurité industrielle – exigences de segmentation, gestion des identités et auditabilité des flux. |
| ISO/IEC 27001 | Système de management de la sécurité de l’information (SMSI) ; contrôle d’accès aux données sensibles. |
| DORA (secteur financier) | Résilience opérationnelle numérique – exigences de continuité et de test de récupération, applicables aux fournisseurs de services cloud utilisés par les industriels. |
L'application de ces cadres nécessite une cartographie des risques (ISO 31000), l'établissement d'un registre des traitements (RGPD) incluant les flux IoT, ainsi que des processus de revue périodique pour aligner les exigences légales et les pratiques opérationnelles.
9 Cas d’usage : maintenance prédictive dans une usine de production d’acier
Contexte
Une aciérie de 2 000 emplois souhaite réduire les arrêts imprévus des fours à arc électrique. Les capteurs installés sur les installations produisent un volume massif de données temporelles dont la qualité doit être rigoureusement contrôlée avant toute injection dans un modèle de maintenance prédictive. L'enjeu réside ici dans la capacité à transformer ces signaux bruts et bruités en indicateurs fiables, capables de soutenir des décisions opérationnelles critiques.
Conclusion opérationnelle
La valeur des flux IIoT pour l’IA dépend de la fiabilité et de la traçabilité des données, pas seulement de leur volume. Pour qu’une décision automatisée ou une analyse prédictive soit opposable, le pipeline doit préserver leur intégrité, leur provenance et leur qualité, de la capture à la périphérie (Edge) jusqu’au stockage cloud. Il faut donc dépasser le simple monitoring et mettre en place une infrastructure de données certifiée.
Pour appliquer cette approche, nous recommandons de commencer par un audit de traçabilité sur un périmètre pilote. Cartographiez les flux critiques et mettez en place un mécanisme de hachage ou de signature numérique dès la source. Vous pourrez ainsi vérifier l’immuabilité des données terrain avant leur intégration aux modèles d’IA et établir une base technique pour une gouvernance industrielle auditable.